Dieselbe Zeilenfläche auf fünf Blättern, nach unten immer blasser — und die Spur, die durch den Stapel läuft, versiegt, bevor sie unten ankommt.
Mein Werkzeug hält meinen Agenten auf
An einem Septembertag blockiert mein eigener Guard meinen eigenen Agenten. Der will eine Datei löschen, die er zwei Stunden zuvor selbst angelegt hat, und greift dafür zu einer Schreibweise, an der mein Shell-Alias vorbeigeht — nicht auf meine Anweisung, die Wahl traf er selbst. rm-trash-guard schiebt sich dazwischen: kein endgültiges Löschen, sondern die Umleitung in den Papierkorb. Der Löschbefehl läuft nicht, die Umleitung trägt. In derselben Sitzung wacht commit-nag darüber, dass keine Änderung an meinem Regel-Store uncommittet liegen bleibt.
Beides tut, wofür ich es gebaut habe. Und beides habe ich gebaut. rm-trash-guard steht auf dem Weg, den ein Befehl nimmt: vor der Ausführung, in jeder Sitzung aktiv, blockierend statt beratend. Merk dir die Stelle: Nicht was eine Regel sagt, entscheidet am Ende, sondern wo sie steht.
Was sonst in diesem Store steht: 12 Hook-Skripte, davon 6 blockierende Guards. 63 Permission-Regeln. 406 Zeilen selbstgeschriebene Regeln, verteilt auf zwei Dateien: eine globale, die in jeder Sitzung mitgeladen wird, und eine projektlokale. Und alle zwölf Skripte feuern ausschließlich innerhalb einer Agenten-Sitzung — aus meiner eigenen Shell feuert keines davon. Der Apparat existiert nur gegen den Agenten.
Das ist der Widerspruch, der diesem Text seinen Namen gibt: Ich setze ein Werkzeug ein, weil ich ihm zutraue, Code zu schreiben, und baue mit demselben Werkzeug einen Apparat, der davon ausgeht, dass es das nicht kann. Dieselbe Regel steht zweimal da — einmal als Bitte an den Agenten, einmal als Sperre gegen ihn. Die Szene von eben ist so ein Paar: Vorn steht die Umleitung in den Papierkorb, an der eine andere Schreibweise vorbeiläuft — hinten der Guard, der genau die aufhält.
Das ist kein Argument gegen den Käfig — gegen die Prüfschicht also, die das Ergebnis von Agenten absichern soll. Die unbequemere Frage, auf die dieser Text hinausläuft: Könnte überhaupt jemand die Rechnung für den Käfig aufmachen?
Das Korsett ist gewachsen, nicht entworfen — ein Stapel ohne Architekten
Die Staffel und ihr Preisschild
Mein Store ist dabei der einfachste Fall: Regeln, die nur ich trage und nur ich durchsetzen muss. Eine Ebene weiter, wo ein Team dieselben Prüfungen mitträgt, sieht es anders aus — ein Kundenprojekt, ein Monorepo mit zehn Teilprojekten, 38 Hook-Einträge.
Die sind auf zwei Stufen verteilt, und die Stufen bauen aufeinander auf. Beim Commit laufen 20, über die geänderten Dateien. Beim Push alle 38, weil kein Eintrag die Push-Stufe auslässt — die 20 vom Commit sind darin enthalten. In der CI dieselben 38, dort aber über alle Dateien des Repos. Die Stufentrennung halbiert nicht, sie staffelt: 20 → 38 → 38, und die letzte Stufe prüft nicht mehr nur das Geänderte, sondern alles.
Jede Position hat ein Preisschild, und man muss dazusagen, was gemessen wurde. Über eine geänderte Datei: 2,29 Sekunden warm für die Commit-Stufe, 36,30 für die Push-Stufe. Das ist ein manueller Lauf, kein Commit-Kontext; die kalten Werte — 3,16 und 51,02 Sekunden — sind warm-kalt, nicht der Preis eines frischen Klons. Über den gesamten Baum in der CI: 907 Sekunden im Median über elf echte Workflow-Läufe; im jüngsten davon entfielen 817 Sekunden auf den Hook-Schritt allein. Die dritte Zahl ist keine dritte Stufe derselben Treppe — sie misst einen anderen Gegenstand und beziffert, was die vollständige Abdeckung als Wartezeit kostet.
Gut zwei Sekunden für die Commit-Stufe sind wenig; daran scheitert kein Arbeitstag. Die Staffelung ist auch richtig gebaut: Jede Stufe kauft mehr Abdeckung für mehr Zeit, von billig nach teuer. Was anfällt, fällt trotzdem an — es ist nur kein Verschnitt, sondern der Preis der Abdeckung.
Dazu die Zahl, die ich nicht wegglätten darf: Von den 20 aufgeführten Commit-Prüfungen haben 4 gearbeitet, von den 38 beim Push nur 6. Der Rest wird übersprungen, und zwar absichtlich — jede Prüfung sieht nur die Dateien ihres Teilprojekts, und was eine Änderung nicht berührt, läuft gar nicht erst an. Das ist die sparsame Bauweise, nicht der Leerlauf. Nur darf man die aufgezählte Zahl dann eben nicht mit der Laufzeit multiplizieren: Wer „38 Hooks" sagt und 36 Sekunden danebenstellt, suggeriert genau das. Es waren sechs.
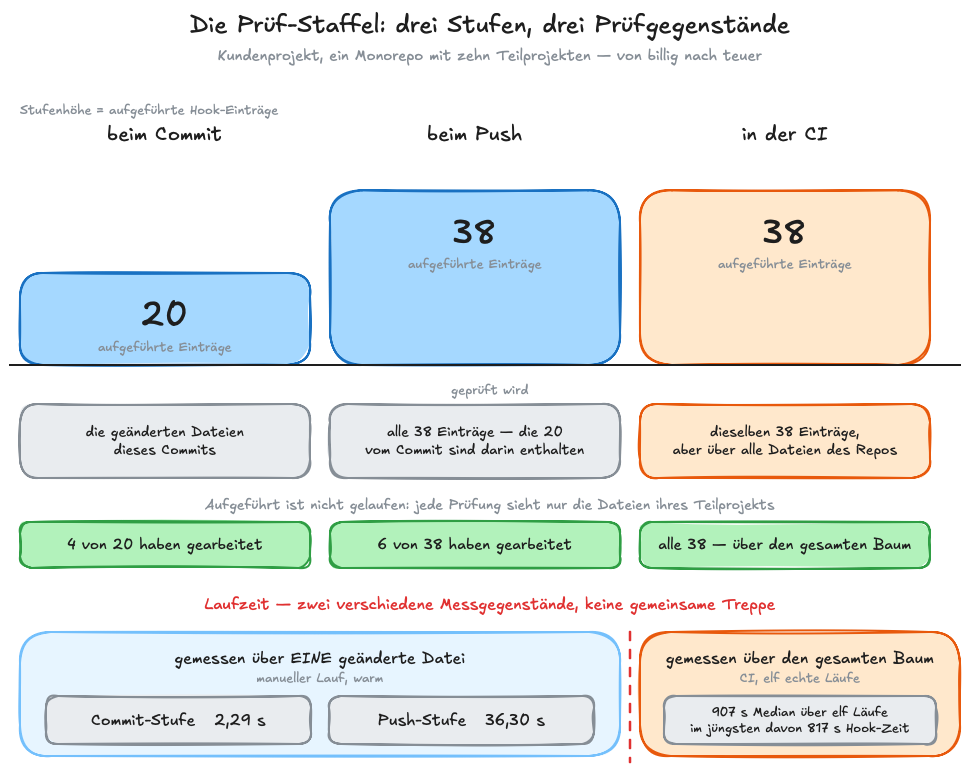 Die Treppe zeigt, was aufgeführt ist; die Zeile darunter, was gelaufen ist. Die Laufzeiten stehen getrennt daneben — die ersten beiden messen eine Datei, die dritte den ganzen Baum.
Niemand kennt den Betriebszustand
Jede Schicht misstraut der darunterliegenden. Bei mir ist das kein Deutungsangebot, sondern steht so in den Skripten: Jedes trägt oben eine Zeile, die seinen Zweck nennt. Ein Guard existiert, um den Agenten am Umgehen der git-Hook-Ebene zu hindern. Ein zweiter existiert nur, damit ein anderer funktionieren kann: Der eine schreibt den Marker, den der andere prüft. Zwei von zwölf Skripten sind so ein Paar.
Eine Schicht kann installiert, getestet und trotzdem wirkungslos sein. Einer meiner Guards lief fail-open — ausgerechnet der Fall, den er selbst als den gefährlichsten führt, war in einem seiner Zweige der stillste. Sein Fix griff nicht und musste elf Tage später dreimal nachgezogen werden. Ein Test existierte durchgehend und wurde im wirkungslosen Fix sogar mit erweitert: grün, während die Lücke offenblieb. Falsch lag vor allem eine Rückfrage, die auch bei Befehlen ansprang, die gar nichts gefährdeten. Im Code steht der Satz, der die Kostenart mitliefert — „eine Warnung, die zu oft falsch liegt, schützt nicht mehr, sondern erzieht zum Wegklicken."
Als der Stapel vermessen wurde, stand der präziseste Einzelbeleg im Kundenprojekt, in einer Zeile der CI-Konfiguration: Sie übergab das Stage-Argument zweimal. Das Argument nimmt nur einen Einzelwert, die zweite Angabe überschrieb also die erste — effektiv lief nur die Push-Stufe. Das Ergebnis stimmte trotzdem, aber nur zufällig, weil die Push-Stufe ohnehin alle 38 Einträge enthält. Zwei Fehler hoben sich auf, und deshalb fiel keiner auf.
Dass ein Wächter lautlos falsch laufen kann, ist keine Entdeckung von mir. Tobias Mogdans beschreibt es in Teil 6 seiner Käfig-Serie selbst, mehrfach an verschiedenen Nähten: Ein Merge-Gate leitete zwischenzeitlich die Risikostufe ab, ohne sie zu nutzen, und dieselbe Fehlerform tauchte in dem Projekt, an dem er die Staffelung erprobt, an mehreren Stellen der Kette wieder auf — „eine Fehlerform, die an jeder Naht neu entstehen kann, an der ein Gate sitzt". Mein Fall zeigt dieselbe Klasse aus der anderen Richtung: bei ihm installiert und falsch konfiguriert, Effekt zu viel Prüfung; bei mir konfiguriert und gar nicht installiert, Effekt keine Prüfung.
Und dann die Lücke, von der ich nicht wusste, dass es eine ist. Die 63 Permission-Regeln aus der Eröffnung sind ausschließlich Erlaubnisse: keine einzige Verbotsregel, keine einzige Rückfrage — und die Dateisuche steht auf der Erlaubnisliste. Die sechs blockierenden Guards decken das Löschen ab, destruktive git-Kommandos, das Umgehen der Hook-Ebene, das Entfernen von Arbeitsverzeichnissen, ungeprüfte Pull-Requests und den Transport von Planungsdateien. Eine Suche ohne Pfadgrenze fängt keiner von ihnen ab — nicht, weil die Ebene es nicht könnte, sondern weil dieser Guard nicht existiert.
Das trifft mich an der Stelle, die ich oben den einfachsten Fall genannt habe: ein Stapel, der einer einzigen Person gehört. Keine verteilte Verantwortung, kein Team, keine 38 Einträge — und der Eigentümer kannte seinen eigenen Betriebszustand trotzdem nicht.
Bis hierhin lauter Ausfälle — und sie stehen neben einem Apparat, der bei jedem Commit und in jeder Sitzung anläuft und dabei tut, wofür er gebaut wurde. Genau deshalb ist der Betriebszustand überhaupt eine Frage wert: Wer ihn nicht kennt, kann die Kosten einer Schicht nicht buchen — die Rechnung für den Käfig steht schon hier auf wackligem Grund. Mein eigener Fall ist gemessen, und er ist das Kernbeispiel dieses Textes.
Dieselbe Regel, dreimal kodiert — und die dritte ist tot
Die Absicht ist banal: Commit-Nachrichten sollen Conventional Commits folgen. Bei mir ist sie an drei Positionen der Kette kodiert.
Vorn als Prosa in der globalen Regeldatei, die in jeder Sitzung mitgeladen wird und jedes Mal Kontext kostet. In der Mitte als getracktes Commit-Template, in einem eigenen Werkzeug-Repo per Konfiguration aktiv; es kostet keinen Kontext. Hinten, im selben Repo, als commit-msg-Hook, der ebenfalls keinen Kontext kostet — wenn er verdrahtet ist.
Das Template ist der eigentliche Fund: beratend wie die Prosa und trotzdem kostenlos. Damit fallen Kosten- und Wirkungsachse auseinander, und „vorn billig und unsicher, hinten teuer und sicher" ist zu grob. Es gibt eine Position, die billig und beratend ist.
Die drei Kodierungen widersprechen sich bereits. Die Prosa nennt 11 erlaubte Typen, das Template dieselben 11 und darunter zwei weitere, und die dritte Liste gibt es gar nicht — die Konfigurationsdatei, die der Hook bräuchte, war nie getrackt. Der jüngste eigene Commit dieses Repos trägt einen Typ, der in keiner der drei Listen steht.
Die hintere Position ist nicht aus einem Grund tot, sondern aus dreien. Das Hook-Verzeichnis existiert nicht — nicht „ist leer", es fehlt; ein frisches git init legt es an, es wurde also nachträglich entfernt. Ein alternativer Hook-Pfad ist nicht gesetzt. Und das Werkzeug, das der Hook aufruft, ist systemweit nicht installiert. Drei unabhängige Gründe, und keiner ist der Konfigurationsdatei anzusehen: Die behauptet weiterhin neun Kommandos über drei Events. Das Hook-Framework selbst ist installiert, nur nicht verdrahtet.
Warum das Verzeichnis fehlt, weiß ich nicht, und dabei bleibt es.
Dahinter steht etwas, das für jedes Hook-Framework gilt: Die Konfiguration ist versioniert und kommt mit jedem Klon mit, die Aktivierung liegt außerhalb der Versionskontrolle und entsteht nur durch einen separaten Schritt. Eine Schicht kann verschwinden, ohne dass es irgendwo sichtbar wird — kein Diff, kein Commit, keine Meldung.
Wie viel dieses eine Repo trägt, gehört dazugesagt: vier Commits, alle aus zwei Tagen im Juli 2025, seither ruht es. Ob der Hook je gegriffen hat, ist nicht mehr feststellbar. Der Befund hängt daran nicht — er ist die Absicht, dreimal kodiert, mit drei Fassungen, die auseinanderlaufen.
Und dann tut der Befund etwas, das mir nicht in den Kram passt: Die billige, unsichere Prosa-Regel gilt bis heute, die teure, sichere Hook-Regel nicht mehr. Vorn war hier auch robuster. In einem ruhenden Repo ist das kein starker Beleg — aber es löst die Frage nach der Platzierung eben auch nicht auf, es macht sie interessanter, und ich lasse es so stehen, statt es glattzuziehen.
Zum Schluss dreht sich der Befund auf mich selbst zurück. Am Tag vor der Sitzung aus der Eröffnungsszene habe ich einen Skill und einen Agenten gebaut, semantic-twins und semantic-twin-hunter, die mit Agenten nach semantischen Zwillingen suchen — nach Typ-4-Klonen: Code, der dasselbe tut, aber anders geschrieben ist, und den die üblichen Detektoren deshalb nicht finden. Als zweite Zwillings-Klasse führt die Agent-Beschreibung eine Regel, die ein zweites Mal in einer anderen Schicht kodiert ist, und der Rumpf der Agent-Definition nennt genau den Fall „with the two already differing". Mein eigener Detektor sucht exakt diesen Defekt; in meinem eigenen Regelwerk lag er dreifach vor — als die Commit-Regel von eben — und war unbemerkt. Älter als die These dieses Textes ist der Detektor auch — nachgebaut ist er ihr also nicht.
Und dieser Defekt ist kein Einzelfall: Die Papierkorb-Regel aus der Eröffnungsszene stand in meiner Shell-Konfiguration zweimal. Die eine Stelle leitete ins Papierkorb-Werkzeug um, die andere ließ den endgültigen Löschbefehl stehen und hängte ihm nur eine Rückfrage an. Zur Laufzeit gewann die erste; die schwächere Fassung stand weiter da, unbemerkt. Zwei unabhängige Absichten, beide mehrfach kodiert, beide bereits divergent, beide unbemerkt.
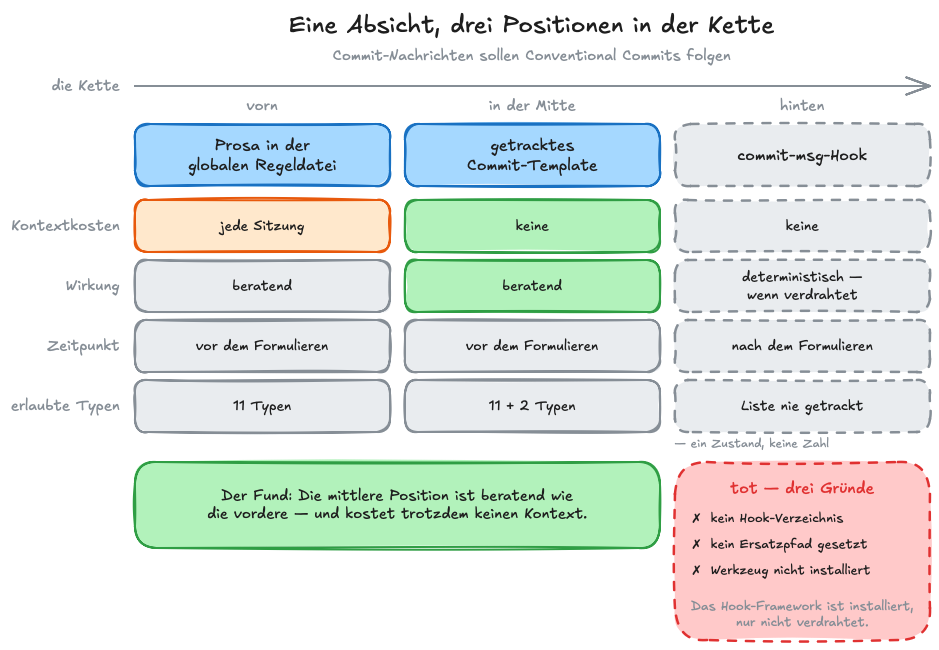 Dieselbe Absicht an drei Positionen der Kette, je mit Kostenprofil und Typenliste. Die mittlere ist beratend wie die vordere und kostet trotzdem nichts; die hintere ist aus drei unabhängigen Gründen wirkungslos.
Drei Positionen, drei Kostenprofile, und niemand, der sie je gegeneinander gerechnet hätte. Vor der Rechnung muss ich allerdings eine bequeme Annahme loswerden: dass dieser Stapel überhaupt von den Agenten kommt.
Der Stapel ist älter als die Agenten
Die Prüfschicht stand vor den Agenten da, und sie wächst mit Teilprojekten
Zuerst noch einmal das Kundenprojekt — das Monorepo mit den 38 Hook-Einträgen.
Die Prüfkonfiguration liegt dort im allerersten Commit des Repos — derselbe SHA, dieselbe Sekunde. Die Regeldatei, die heute den Agenten führt, kam 220 Tage später. Der Stapel ist also nicht bloß älter als die Agenten, er ist so alt wie das Repo.
Auch das Wachstum ist nicht agenten-getrieben. In den gut sieben Monaten vor der Agenten-Regeldatei stieg die Zahl der Einträge von 2 auf 20; in den gut neun Monaten danach von 20 auf 38. Nach der Ankunft der Agenten wuchs die Prüfschicht eher langsamer, und die größten Einzelsprünge hängen ausnahmslos an neuen Teilprojekten.
Das ist die bequeme Kausalität, die ich aufgeben musste — und ich kann sie mit einem Zitat aus der Serie aufgeben, an die dieser Text anschließt: „Nichts an diesem Boden ist neu. Linter, statische Analyse, eine ordentliche Testsuite gehörten zum Handwerk, lange bevor der erste Agent eine Zeile schrieb … Geändert hat sich nicht das Werkzeug, sondern der Spielraum."
Und hier schrumpft der Stapel sogar, zweimal. Beide Rückgänge fallen mit Umbauten der Teilprojekt-Struktur zusammen: Die Regeln verschwanden, weil ihr Gegenstand verschwand, nicht weil jemand eine Rechnung aufgemacht hätte. Entfernt wird, was seinen Gegenstand verliert — nie, was nur überflüssig wurde.
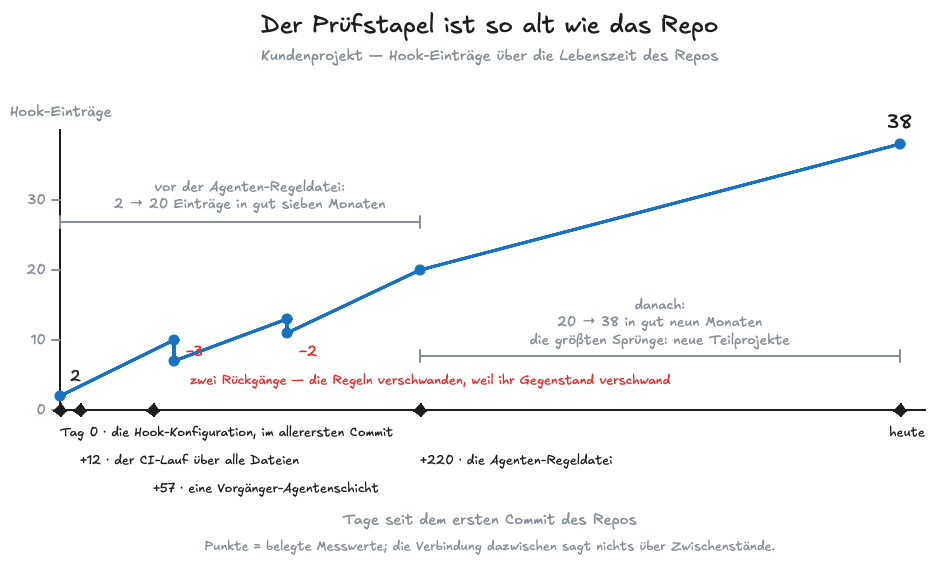 Die Zeitachse beginnt beim ersten Commit des Repos, nicht bei den Agenten — die kommen 220 Tage später. Die zwei Einbuchtungen sind die einzigen Rückgänge, und beide fallen mit einem Umbau der Teilprojekt-Struktur zusammen.
Im eigenen Regel-Store wird keine Regel zurückgenommen
Jetzt der zweite Stapel: mein eigener Regel-Store, in dem kein Prüfgegenstand wegfallen kann.
326 Commits über 118 Tage, keine einzige zurückgezogene Regel. Die globale Regeldatei wuchs von 156 auf 331 Zeilen; von 34 Commits auf sie hat kein einziger mehr entfernt als hinzugefügt. Die regel-relevanten Hook-Registrierungen stiegen von 0 auf 14, verteilt über fünf Hook-Ereignisse, ohne Rückgang. Und die zwei einzigen Rücknahmen im ganzen Store entfernen Erlaubnisse — sie verengen, sie lockern nicht.
Die Nicht-Rücknahme gilt für Regeln, nicht für Dateien, sonst wäre sie mit einem git log widerlegbar: Gelöscht wird durchaus, 26 Dateien in 9 Commits, aber jede Löschung ist Zusammenführung, Verschiebung, Umbenennung-mit-Erweiterung oder Housekeeping.
Elf Tage bevor ich anfing, darüber nachzudenken, hat Addy Osmani dasselbe Muster publiziert — „Audit your Agent files", 27. August 2026; ich kannte den Artikel nicht. Das Wachstum beschreibt er als Reflex: bei jedem Fehltritt des Agenten eine Regel mehr, und das summiert sich weiter auf. Den Grund, warum niemand eine Schicht wieder entfernt, nennt er auch — man stützt sich auf sie wie auf eine Krücke, weil man weder dem Modell noch der Umgebung zutraut, inzwischen ohne sie auszukommen.
Und der Satz, den ich mir aufgeschrieben habe: „Installing a useful skill and keeping it forever are separate decisions." Wenn zwei Praktiker mit verschiedenen Setups unabhängig dasselbe beobachten, ist es keine Marotte eines Einzelnen mit zu vielen Guards.
Das Muster beschreibt den Normalfall, nicht den einzigen, und der Unterschied gehört direkt daneben. Der bekannteste Guard meines Stores, derselbe, der in der Eröffnungsszene blockiert, entstand aus einer Messung meiner eigenen Historie: 422 Löschaufrufe in den Protokollen vergangener Sitzungen — Spezifikationen, Quelldateien, sogar eigene Regel-Dateien. 223 davon hätte er geblockt. Kein Agenten-Fehltritt also — und auch kein Regelbruch, denn eine Regel gab es zu dem Zeitpunkt nicht. Die Zahlen stammen aus derselben Sitzung, in der der Guard entstand — die Zählung, aus der die Regel hervorging, keine Prüfung von außen.
Eine Inventur dieser Schichten gibt es durchaus: Ein ausgeliefertes Werkzeug geht Skills, MCP-Server und Plugins „relative to their context cost" durch. Es deckt genau eine Schicht ab — nicht git-Hooks, nicht CI.
Dass nichts zurückgenommen wird, steht fest. Was es kostet, noch nicht — und bei einer Kostenart arbeitet die Antwort gegen den Zweck des Apparats.
Das Korsett kostet genau die Ressource, die es schützen soll
Kontext ist die einzige Kostenart, die gegen den Zweck des Apparats arbeitet: Regeln sollen den Agenten führen und belegen dafür Platz in dem Fenster, aus dem er sein Verhalten speist. Nur läuft der Mechanismus anders, als ich lange annahm.
Mehr Regeln, schlechtere Befolgung: Diese Kurve hatte ich erwartet, und sie ist nicht belegt — für die Größe der Regeldatei aktiv widerlegt. Eine Untersuchung ließ dafür auf zwei Projekten 1.650 Claude-Code-Sitzungen laufen und zählte in jeder, ob eine einfache Vorgabe befolgt wurde; die Größe der Regeldatei änderte daran nichts — und zwar nicht im Sinne von „nicht nachweisbar", sondern als Evidenz für die Null. Belegt ist stattdessen Konflikt: Eine zweite Untersuchung stapelte bis zu zwanzig geprüfte Anweisungen übereinander, und die Befolgungsrate fällt von rund 96 % auf bis zu 20 % — nicht wegen der Menge, sondern weil je zwei einander widersprechen. Meine dreifach kodierte Commit-Regel ist so ein Fall.
Mein eigener Befund ist ein drittes Muster, weder Menge noch Konflikt: nicht schlechtere Befolgung, sondern Nicht-Übertragung.
Beim Start jeder Sitzung läuft ein Skript, das ich selbst geschrieben habe. Es stellt den Index meines Regel-Stores zusammen — eine Zeile pro Regel — und legt ihn der Sitzung in den Kontext. Was dieses Skript ausgibt, prüft die Umgebung gegen eine harte Grenze: 10.000 Zeichen, an einer konkreten Programmversion abgelesen und mit zwei Kontrollsitzungen bestätigt. Die Grenze gilt für die Ausgabe des Skripts, nicht für die Datei dahinter.
Liegt die Ausgabe darüber, schreibt die Umgebung sie in eine Datei und stellt in den Kontext nur noch deren Anfang: die ersten 2.000 Zeichen. Still ist das nicht: Sie meldet die Auslagerung und nennt den Pfad der Datei — nur meldet sie es dem Modell, nicht mir. Der Hinweis läuft als Anhang mit, nicht als Zeile in dem Verlauf, den ich lese; gesehen habe ich ihn nie. Und welche Einträge fehlen, sagt sie auch dem Modell nicht — dass es sie nachholen soll, ebenso wenig.
Auf dem Höchststand lag meine Ausgabe bei 56.509 Zeichen, gut dem Fünfeinhalbfachen der Grenze. Von 184 Einträgen des Index erreichten 6 den Kontext. Gemerkt habe ich davon nichts.
Heute sind es 9.724 von 10.000 Zeichen: 276 Zeichen Luft, weniger als eine neue Indexzeile, und alle 70 von 70 Einträgen kommen an. Seit dasselbe Skript am 8. September selbst kappt, ist im ausgewerteten Bestand keine Auslagerung mehr aufgetreten. Und es meldet, was die Umgebung nicht meldet, an mich statt an das Modell: welche Einträge weggefallen sind — und seit dem 10. September warnt es schon, bevor überhaupt einer wegfällt. Die Schicht hält — und ist selbst eine weitere, die gewartet werden muss. Gelöst ist nichts: Sie hält, weil sie kappt, und was sie kappt, kommt weiterhin nicht an.
Um diese Grenze herum sind fünf Schichten Regelwerk-Verwaltung entstanden, für das Regelwerk eines Einzelnen, in knapp zwölf Wochen — darunter ein Skript, das die Struktur des Regelwerks prüft, und als jüngste die Warnung an mich, weil die Meldung der Umgebung mich nie erreicht. Zwei Dinge glätte ich nicht: Eine Zusatzregel, die dem Agenten vorschreibt, den Index nur als Ausschnitt zu behandeln und im Zweifel die vollständige Datei zu lesen, entstand, bevor das Skript selbst kappte — sie war also zuerst gegen den fremden Mechanismus geschrieben. Und die erste Gegenmaßnahme, die Konvention der Teil-Indizes, hat das Wachstum nicht gestoppt: Danach wuchs der Index um 148 %.
Lange bevor es diese Kappung gab, am 23. Juni, traf genau diese Konvention eine Regel, die seit knapp vier Wochen im Index stand: vor dem Entfernen eines Arbeitsverzeichnisses prüfen, ob dort noch uncommittete oder ignorierte Dateien liegen. Zwei Tage vorher war ihre Themengruppe — die Git-Regeln — in einen nachladbaren Teil-Index gewandert. Im Hauptindex blieb davon eine einzige Zeile, ein Zeiger auf diesen Teil-Index, und die lag außerhalb der Vorschau: 67 von 75 Einträgen kamen nicht durch. Zeiger nicht zugestellt, Ziel nur auf Abruf — die Gegenmaßnahme machte die Regel unerreichbar.
Der Schaden trat ein: Gelöscht wurde eigenes Werkzeug-Tooling aus meinem Core-Keeper-Mod-Projekt, selbstgeschriebener Code, kein Wegwerf-Material.
Auf meine Rüge hin suchte der Agent die Regel, fand sie und schloss: ein Disziplin-Fehler, kein Wissens-Fehler. Beides unzutreffend — die Ausgabe des Startskripts war an dem Tag ausgelagert worden, nicht in den Kontext gelegt. Er schärfte den Regeltext nach, statt zu bemerken, dass der Text ihn nie erreicht hatte: ein Zustellungsfehler, gedeutet als Disziplinproblem, beantwortet mit mehr Regeltext, der dieselbe Zustellung belastet. Vierzehn Minuten später stand dieselbe Regel als blockierender Hook hinten in der Kette, am Befehl statt im Kontext — dort muss sie nicht mehr zugestellt werden. Derselbe nachgeschärfte Eintrag trägt die falsche Ursache und einen Satz weiter die richtige Konsequenz: Der Auslöser müsse am Befehl hängen, nicht am Erinnern. Die Platzierungsfrage war beantwortet, ohne dass jemand sie gestellt hätte. Meine Rüge war zu dem Zeitpunkt berechtigt — niemand konnte wissen, dass die Regel nie ankam. Kein Vorwurf an mich, keine Entlastung des Agenten: zwei, die auf eine Zustellung vertrauten, die niemand prüfen konnte.
Es war die dritte Wiederholung: Die Regel hält selbst zwei frühere Anlässe fest, und beim dritten Mal war sie aus dem Kontext gewachsen. Osmanis Muster bekommt hier seine Zuspitzung — der Anlass muss nicht einmal echt sein.
Der härteste Einzelbeleg ist trotzdem kein Vorfall, sondern eine Zahl: Der Eintrag in meinem eigenen Index, der vorschreibt, eine ausgelagerte Ausgabe aktiv nachzulesen, existierte in 190 Sitzungen und kam in keiner einzigen durch die Vorschau. Die Regel gegen die Auslagerung wurde von der Auslagerung verschluckt, ausnahmslos. Belegt ist die Zustellung, nicht die Wirkung — ob die Regel befolgt worden wäre, sagt die Zahl nicht, eine Vergleichsgruppe existiert nicht.
Einen Punkt hatte ich unterschätzt. Tobi hat die Mengenfrage nicht übersehen, er hat sie verworfen: „Die Trennlinie ist nicht ‚Kontext ja oder nein', sondern ‚aus welcher Quelle'" (Teil 5). Und sein eigener Hebel füllt den Kontext: Die Fakten sollen schon im Fenster liegen, bevor der Agent ein Wort schreibt. Seine Therapie belastet dieselbe Ressource, aus der die Regelbefolgung gespeist wird. Und Teil 6, der Kosten-Teil, nennt Kontext kein einziges Mal.
Wie weit das beworbene Kontextfenster vom effektiv nutzbaren entfernt ist, habe ich in einem eigenen Artikel über die Mental Load von Sprachmodellen auseinandergenommen; woher so ein Index kommt, steht in meiner Memory-Serie und im Governance-Teil.
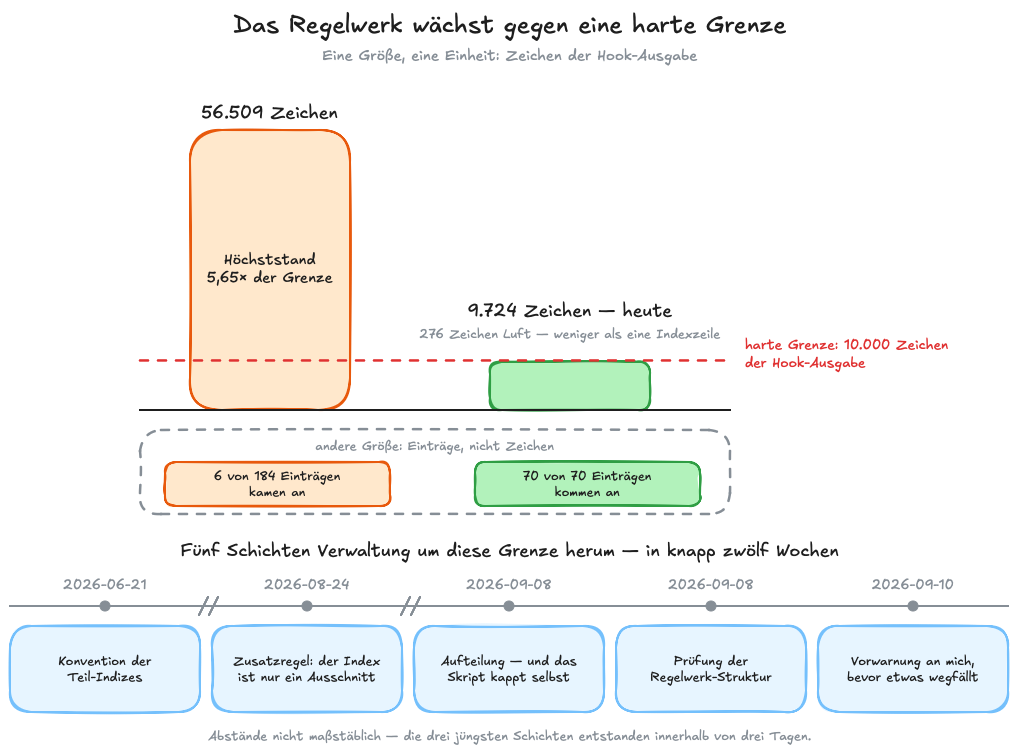 Oben zwei Messpunkte derselben Größe gegen die harte Grenze, darunter — abgesetzt, weil es eine andere Größe ist — wie viele Einträge davon ankamen. Unten die fünf Schichten, die um diese Grenze herum entstanden sind.
Damit liegen die Posten auf dem Tisch. Was fehlt, ist die Rechnung.
Die vollständige Rechnung — was der Stapel pro Durchlauf kostet
Wer eine fremde Rechnung ergänzt, muss sie zuerst korrekt darstellen — sonst ist nicht erkennbar, welche Hälfte fehlt. Also zuerst Tobis Position, so vollständig ich sie wiedergeben kann.
Sein Modell sind zwei Kurven: Die Kosten schlechten Codes summieren sich über die Lebenszeit eines Systems immer weiter auf, die Kosten des Käfigs tun das nicht — sie sind „begrenzt, fallen vorne an und sind Massenware". Die Posten dieser zweiten Kurve benennt er einzeln. Bau ist billiger, als es klingt — „Den Boden baust du nicht, du stellst ihn auf." Betrieb ist „die unterschätzte Rechnung": „CI-Minuten (die kosten echtes Geld), der Durchsatz der Merge-Queue, die Latenz pro Rückkante-Runde, flaky Tests, die Pflege der Ratchets, die Frage, wer auf den Alarm reagiert." Eindämmung kostet in einer anderen Währung, nämlich Reibung. Umgehungsdruck bekommt einen eigenen Abschnitt, und darin diesen Satz: „‚Pareto', ‚good enough', ‚das lohnt sich hier nicht' sind die nächste Fluchttür, das neue .skip." Wartung schließlich ist keine zusätzliche Kostenart, sondern „die Rest-Management-Schleife selbst".
Seine Stopp-Regel ist zweiteilig, und die zweite Hälfte wird leicht überlesen. Auf der Breite stoppt er ökonomisch: „Bau ein Gate, solange das nächste Gate weniger kostet als der Schaden, den es im Mittel verhindert." Auf der Tiefe ausdrücklich nicht über Geld: „Unabhängigkeit, nicht Geld" — gestoppt wird „an dem Punkt, an dem keine unabhängige Schicht mehr übrig ist". Der Merksatz, den er selbst als tragend markiert: „Pareto auf der Breite, nie auf der Tiefe." Gemeint ist damit die Abwägung von eben, nicht die populäre 80/20-Regel — er grenzt das selbst ausdrücklich ab.
Dazu setzt er sich drei Einschränkungen selbst. Erstens drei Zonen, in denen Pareto nichts zu suchen hat — Irreversibilität, Unknown unknowns, der Intent-Abgrund: „Das ist kein Selbstwiderspruch, das ist die eigentliche Aussage: Rechne, wo Rechnen erlaubt ist, und mach unmöglich, wo Rechnen versagt." Zweitens gilt seine Slop-Kurve nur für langlebigen, geteilten Code, und er rahmt diese Grenze selbst als Schutz gegen Selbstimmunisierung. Drittens verweigert er Zahlen bewusst und methodisch begründet: „Das Argument ist stärker, wenn es über die Gestalt läuft, nicht über Werte."
Dass ich trotzdem mit gemessenen Zahlen ankomme, ist deshalb kein Gegenzug. Tobi verweigert erfundene Zahlen für den Ertrag; für die Kostenseite hat er die Posten benannt und offengelassen — „Das gehört ehrlich auf die Rechnung, nicht weggeredet."
| Kostenart | In Teil 6 |
|---|---|
| Bau · Betrieb · Wartung · Reibung | ✅ benannt |
| Latenz pro Durchlauf | ✅ benannt, unter Betrieb |
| Umgehungsdruck | ✅ eigener Abschnitt |
| Überblick | 🟡 als Phänomen da (ein Wächter, der lautlos falsch läuft), als Posten nicht bilanziert |
| Erstarrung | 🟡 gewollte Entwurfsentscheidung („Wer die Wächter ändert, löst das höchste Tier aus") |
| Kontext | ❌ die einzige klar unbehandelte Kostenart |
Sechs Kostenarten ausdrücklich benannt, zwei berührt und anders bewertet, eine unbehandelt.
Dass der Zeitgewinn aus der Generierung in Prüfung und Prompting zurückfließt, ist erhoben und nicht hier entdeckt: Die DORA-Auswertung 2025 sagt es ausdrücklich. Was dort nicht steht: dass diese Verifikationsschicht drei verschiedenen Verantwortlichen gehört.
Genau da liegt, was ich ergänze. Die Posten sind benannt, und sie sind gedämpft und begrenzt gerechnet — „Tier-Staffelung dämpft das … macht es aber nicht weg", heißt es in Teil 6. Das setzt eine Instanz voraus, die staffeln kann. Die hat der reale Stapel nicht: Git-Hooks gehören dem Repo, CI-Gates dem Team, Agent-Guards und Regeldateien dem Einzelnen. Was ich ergänze, ist kein Posten, sondern sein Verhalten unter verteilter Verantwortung.
Dasselbe gilt für die Wachstums-These: „Der Käfig wächst mit der Domäne … macht den Käfig mit der Zeit besser, nicht teurer." Für einen Käfig unter einer Verantwortung stimmt das. Der reale Stapel liegt außerhalb dieses Geltungsbereichs — gleiche Form, anderer Effekt.
Dass niemand die Rechnung aufmachen kann, betrifft dabei allein die Breiten-Regel. Auf der Tiefe verlangt Tobi keine Kostenrechnung, sondern ein Designurteil über Unabhängigkeit; dafür braucht niemand eine Stapel-Bilanz. Die Breiten-Regel dagegen setzt voraus, dass die Rechnung jemandem offensteht. Genau das ist nicht der Fall: Keine Instanz kennt den Gesamtstapel.
Daraus folgt die Unterscheidung, um die es mir geht. Investitionskosten amortisieren sich. Kosten pro Durchlauf fallen bei jeder Nutzung neu an und skalieren mit der Größe des Käfigs mal seiner Nutzungshäufigkeit.
Beide Klassen sind der Preis einer Leistung, kein Aufwand ohne Gegenwert. Diese Schichten laufen, und sie fangen ab, wofür sie gebaut wurden — was ihnen fehlt, ist nicht die Wirkung, sondern die Bilanz.
Ich schreibe das als jemand, der dasselbe Tooling in den Claude Code Must-Haves als Gewinn beschrieben hat — die Spannung ist mir bewusst und gehört benannt.
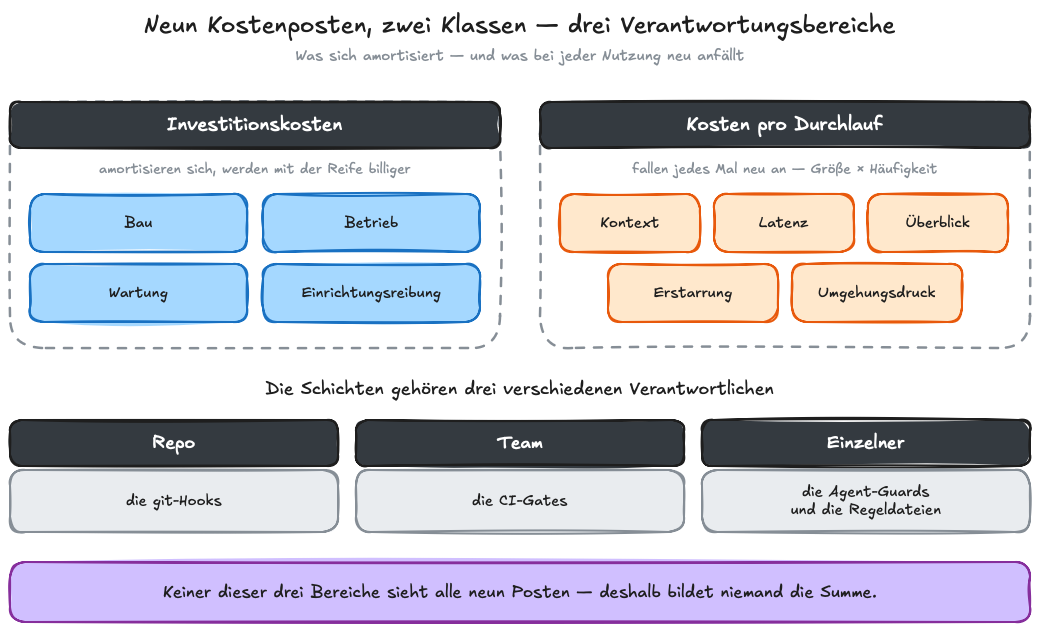 Die neun Posten, einsortiert nach dem einen Kriterium, das sie trennt: Was amortisiert sich, was fällt bei jeder Nutzung neu an? Darunter die drei Verantwortungsbereiche — und keiner von ihnen sieht die ganze Liste.
Nicht ob, sondern wo
Der eine Hebel, den meine Funde tragen, ist keine Empfehlung, wie viel Regelwerk richtig ist. Er ist eine Frage der Position: Nicht ob eine Regel existiert, entscheidet, sondern an welcher Stelle der Kette sie steht. Der Beleg ist die dreifach kodierte Commit-Regel — drei Positionen einer Absicht, drei Kostenprofile, bereits divergent.
Dass die vordere Position billig ist, weiß jeder, der sie benutzt. Dass sie unsicher ist, war mir lange klar. Was ich nicht wusste, war die Größenordnung. Inzwischen ist sie es dreifach, in drei verschiedenen Arten.
Sie kann verschluckt werden. Der Eintrag aus meinem Index, der das Nachlesen der ausgelagerten Ausgabe vorschreibt, kam in 0 von 190 Sitzungen durch die Vorschau.
Sie kann ankommen und ignoriert werden. In einer der ausgewerteten Sitzungen kam eine zweite Regel gegen dieselbe Auslagerung auf Platz 1 der Vorschau an — und wurde trotzdem nicht befolgt.
Und sie kann gar nicht alles erreichen, was sie soll. Die Papierkorb-Regel ist vorn ein Kürzel der Shell: Es ersetzt den Löschbefehl durch die Umleitung, aber nur, wenn er das erste Wort der Kommandozeile ist. Anders geschrieben läuft er daran vorbei — gemessen fängt das Kürzel 1 von 8 Aufrufmustern ab. Der Guard dahinter sitzt vor dem Start der Shell und sieht sie alle acht.
Die dritte Art ist qualitativ anders: Verschlucken und Ignorieren sind Zustellungsfehler, die Reichweite ist eine Bauform-Grenze. Die Regel kommt an und wird befolgt — sie deckt nur nicht ab, was sie abzudecken scheint.
Der Hebel ist nicht neu, und das sage ich lieber selbst. Osmani hat ihn publiziert: „if a rule must always hold, encode it in a test, hook, or permission rather than leaving it as prose the model might lose." Ich kannte den Satz nicht, als ich die Beobachtung machte. Mein Beitrag ist nicht die Erstentdeckung, sondern die Aggregation über Schichtgrenzen, der gemessene Feldfall und der Verantwortungs-Befund.
Rezepte gebe ich keine: Die naheliegenden Aufräum-Rezepte sind von der Empirie nicht gedeckt, und für den naheliegendsten Reflex, besseres Prompting, gibt es Gegenbefunde; Tobis Teil 1 kommt zum selben Schluss. Zu Ende gedacht führt die Platzierungsfrage zu Spezifikation vorn statt Reparatur hinten, dem Hebel aus meiner SDD-Serie. Wohin die vollständige Rechnung führt, ob engeres Korsett, kleinere Aufgaben oder Akzeptanz der Kosten, entscheide ich hier nicht.
Zurück zu dem Guard vom Anfang. Er ist selbst eine Regel an einer bestimmten Stelle der Kette: vor der Ausführung, in jeder Sitzung aktiv, blockierend. Und er sitzt dort, weil die vordere Kodierung nicht reichte — sie wurde gebaut, gemessen und noch in derselben Sitzung durch den Guard ergänzt. Was ich hier als Frage stelle, hatte ich damit längst entschieden: gut drei Wochen früher, und ohne zu merken, dass ich etwas entschied.
Deshalb lautet die Frage nicht: Hast du zu viele Regeln? Sondern: An welcher Stelle der Kette steht deine — und was kostet sie dort? Und die unbequemere Hälfte: Könntest du die Rechnung überhaupt aufmachen?
Dieser Artikel erschien ursprünglich auf dem Mayflower Blog.