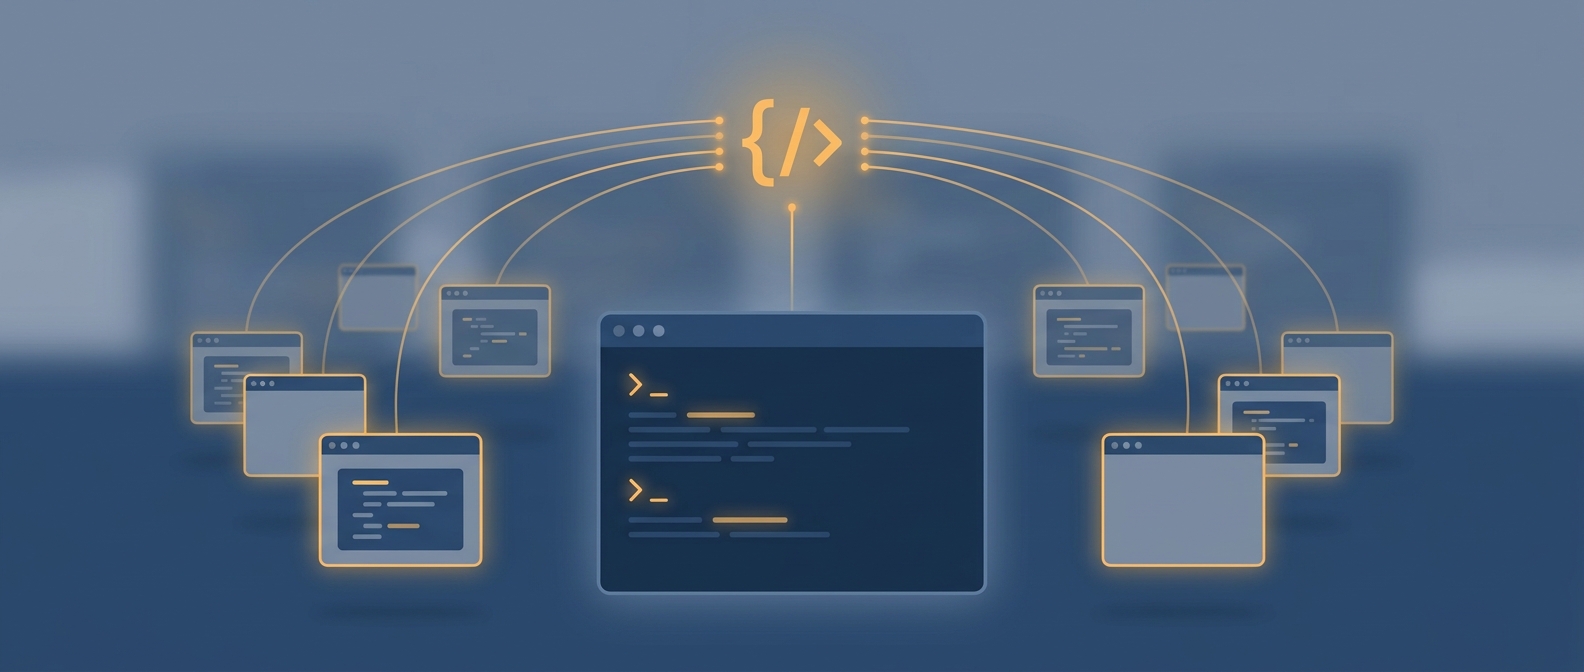
Ein Workflow orchestriert nebenläufige Subagenten im Hintergrund — die neue Koordinations-Ebene sitzt innerhalb einer einzelnen Aufgabe.
Im März drehte sich diese Serie um Werkzeuge: welche Plugins, welche MCPs, welche Skills in meinem Stack landen. Drei Monate später hat sich die eigentliche Frage verschoben — sie lautet nicht mehr „welche Werkzeuge", sondern: wer dirigiert die Arbeit, und auf welcher Ebene? Wie ich arbeite, hat sich dabei nicht geändert: mehrere Fenster und Tabs, mehrere Aufgaben im Projekt, mehrere Projekte parallel, von Hand jongliert — wie im März. Neu ist eine Ebene darunter: Innerhalb einer einzelnen Aufgabe orchestriert das Werkzeug jetzt selbst Subagenten. Ein einziger Workflow kann im Hintergrund bis zu 16 nebenläufige und 1.000 Agenten insgesamt steuern — geschrieben als Skript statt von Hand. Wer am Schluss noch zweifelt, dass das etwas verschiebt — die Antwort steht im Fazit.
Dieser Artikel ist wie immer ein frischer Snapshot: Was ich heute wirklich nutze, warum, und wie es zusammenhängt. Kein Tutorial, kein vollständiger Feature-Guide — eine kuratierte Bestandsaufnahme aus meiner täglichen Praxis. Der Stack ist erstaunlich stabil geblieben — und meine Arbeitsweise auch; verlagert hat sich, was innerhalb einer einzelnen Aufgabe läuft.
Quick Setup: Was sich seit März verschoben hat
Der Kern aus der März-Ausgabe steht: Language Server, Superpowers, Context7, Browser-DevTools-MCPs. Was sich verändert hat, ist nicht der Katalog — es ist die Ebene darüber. Hier nur das Delta, kein Voll-Stack.
Absolut essentiell:
| Tool | Typ | Was sich geändert hat |
|---|---|---|
| Opus 4.8 | Modell | Neuer High-Effort-Default; /effort regelt die Stufe — ich fahre high, xhigh situativ für die härtesten Tasks |
| Superpowers | Plugin | Bleibt das Skill-Rückgrat — unverändert essentiell |
| pr-review-toolkit | Plugin | Unverändert: täglicher Multi-Agent-PR-Review vor jedem Merge |
Täglich im Einsatz:
| Tool | Typ | Was sich geändert hat |
|---|---|---|
mayflow | Plugin/Marketplace | Eigener Marketplace, die sichtbarste Neuerung im Plugin-Setup |
| Context7 | Plugin | Jetzt als Marketplace-Plugin verfügbar (context7@claude-plugins-official) |
Bei Bedarf:
| Tool | Typ | Was sich geändert hat |
|---|---|---|
| Fast Mode | Modell-Modus | 2,5× Speed bei 2× Kosten auf Opus 4.8 — situativ für schnelle Iterationen, nicht im Dauereinsatz |
fallbackModel | Setting | Bis zu 3 Fallback-Modelle; --fallback-model jetzt auch interaktiv (vorher nur -p) |
/safe-mode | Command | Deaktiviert CLAUDE.md, Plugins, Skills, Hooks, MCP fürs Troubleshooting |
# Mein Default für hohen Effort; --effort xhigh ziehe ich nur situativ
claude --effort high

# Fallback-Kette (bis zu 3), funktioniert jetzt auch interaktiv
claude --fallback-model claude-opus-4-7
Diese Features sind mit Version 2.1.154 in den Stack gekommen — ausgerollt am 28. Mai 2026, zeitgleich mit Opus 4.8. Dazu kommen zwei Detail-Stellschrauben, die ich nutze: Bei mir läuft alwaysThinkingEnabled: true, aber das Gegenstück existiert nun feinkörnig — MAX_THINKING_TOKENS=0 oder --thinking disabled schaltet Thinking pro Modell aus, und die Thinking-Summaries werden gruppiert und gekappt (v2.1.166/183). Und der „Lean System Prompt" ist seit v2.1.154 neuer Default für alle Modelle außer den älteren — weniger Boilerplate-Kontext bei jedem Start.
Das eigentliche Delta steht bewusst nicht in diesen Tabellen: Es ist kein einzelnes Tool, sondern wer die Tools koordiniert. Genau dazu gleich.
Orchestrierung: Eine neue Ebene in der Aufgabe
Das ist der Kern dieser Ausgabe — aber nicht so, wie es zuerst klingt. Im März habe ich beschrieben, wie ich mehrere Claude-Code-Fenster parallel betreibe: von Hand gestartet, von Hand zugeteilt, von Hand im Blick behalten. Das mache ich genauso weiter — eine Aufgabe pro Fenster, mehrere Aufgaben und Projekte nebeneinander. Was dazugekommen ist, sitzt darunter: innerhalb einer einzelnen Aufgabe übernimmt jetzt das Werkzeug die Koordination der Subagenten.
Dynamic Workflows sind die zentrale Neuerung. Statt einen Task in einem Chat abzuarbeiten, schreibt Claude pro Aufgabe ein kleines JavaScript-Programm, das im Hintergrund nebenläufig Subagenten steuert — bis zu 16 nebenläufige und 1.000 Agenten insgesamt pro Run. Den Fortschritt sehe ich live über /workflows. Das Feature ist GA und läuft in der CLI, im Desktop-Client und in der VS-Code-Extension. Getriggert wird ein Workflow über das Keyword ultracode (violett hervorgehoben); der alte Trigger workflow funktioniert nicht mehr. Ehrlich gesagt setze ich das selbst erst seit Kurzem ernsthaft ein.
Wichtig ist die Abgrenzung, denn hier werden gern zwei Sorten Parallelität verwechselt. Die eine ist meine alte: mehrere Fenster, jedes an einer eigenen Aufgabe — die bleibt, daran ändert ein Workflow nichts. Die andere ist neu und steckt in einer einzelnen Aufgabe: fan-out, pipeline, verify, die vorher entweder linear in einem Chat liefen oder gar nicht. Ich beschreibe das Ziel, und der Workflow fächert die Arbeit selbst auf, sammelt die Ergebnisse ein und prüft sie — deterministisch, als Skript. Ein Workflow bearbeitet dabei immer nur eine Aufgabe; die Aufgaben nebeneinander jongliere weiter ich.
Der Unterschied zum manuellen Parallelisieren ist nicht graduell, sondern qualitativ: Wollte ich eine Aufgabe früher in parallele Stränge zerlegen, hing das an meiner Aufmerksamkeit — vergesse ich einen Strang, bleibt er liegen. Der Workflow dagegen fächert jedes Mal gleich auf, in derselben Reihenfolge, deterministisch statt von meinem Kurzzeitgedächtnis abhängig. Der Gewinn ist also Reproduzierbarkeit, nicht nur Geschwindigkeit.
Diese Determinismus-Verschiebung greift in ein zweites Delta: Autonomie. Auto Mode braucht keine separate Zustimmung mehr (v2.1.152), und der Sicherheits-Klassifikator erkennt Datenexfiltration und gefährliche Pfade zuverlässiger. In Kombination mit Workflows heißt das: Ein orchestrierter Lauf kann längere Strecken am Stück abarbeiten, ohne dass ich jede Stufe einzeln freigebe — die Leitplanken liegen im Werkzeug, nicht in meiner Anwesenheit. Das ist der praktische Hebel, der Orchestrierung überhaupt erst lohnenswert macht: Ein Workflow, der bei jedem Subagenten auf eine Bestätigung wartet, wäre langsamer als die Handarbeit, die er ersetzen soll.
Dazu kommen rekursive Subagenten: Ein Subagent kann selbst wieder Subagenten spawnen, bis zu fünf Ebenen tief (v2.1.172). Das ist mächtig, aber nicht ohne Kanten. Der ehrliche Caveat gehört dazu: GitHub-Issue #68619 meldet Rekursions- und Token-Probleme bei verschachtelten Subagenten — zum Redaktionsschluss offen. Mein Build deckelt die Verschachtelung zwar bereits auf fünf Ebenen — auch im Vordergrund, seit v2.1.181 —, aber ein weiterer Fix dazu (v2.1.187) ist angekündigt und noch nicht eingespielt. Wer rekursive Subagenten in der Tiefe einsetzt, sollte das im Hinterkopf behalten.
Die dritte Mechanik im Cluster: implizite Agent-Teams. Die expliziten Tools TeamCreate/TeamDelete sind weg (v2.1.178); stattdessen hat jede Session ein implizites Team, und Teammates werden direkt über den name-Parameter des Agent-Tools gespawnt. Das experimentelle Agent-Teams-Feature selbst — echte Peer-Instanzen — kommt weiter unten in „Where Things Stand"; hier geht es nur um die implizite Mechanik, die das Spawnen vereinfacht.
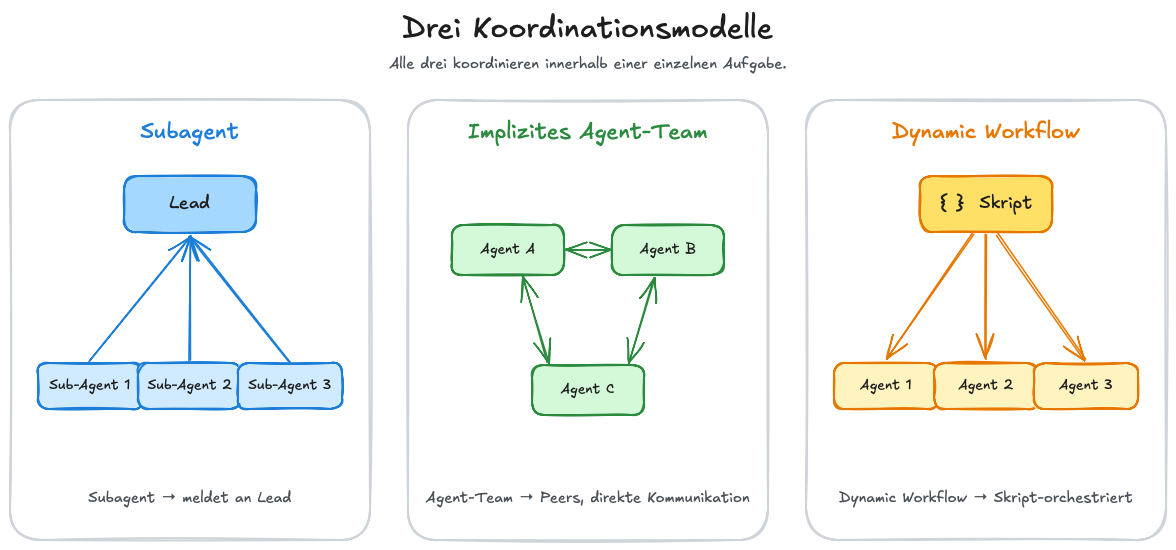 Drei Koordinationsmodelle im Vergleich — der Subagent meldet an den Lead zurück, Agent-Teams arbeiten als Peers, und ein Dynamic Workflow orchestriert beides per Skript.
★ Insight ──────────────────────────────────────────────────────────────────Die eigentliche Verschiebung seit März ist nicht „mehr Tools", sondern eine zweite Koordinations-Ebene. Über den Aufgaben trage ich die Last weiter selbst: Fenster starten, Projekte im Blick behalten, Aufgaben zuteilen — wie immer. Neu ist die Ebene darunter: Innerhalb einer einzelnen Aufgabe koordiniert das Werkzeug — es fächert auf, sammelt ein und prüft. Nicht „der Mensch koordiniert nicht mehr", sondern „es wird jetzt auf zwei Ebenen koordiniert, und die untere ist neu automatisiert".
────────────────────────────────────────────────────────────────────────────
Plugins: Die offizielle First-Party-Directory
Plugins gab es schon im März — aber sie kamen über Community-Marketplaces, die ich von Hand hinzufügen musste (/plugin marketplace add obra/superpowers-marketplace und ähnlich). Heute beziehe ich sie über die offizielle, von Anthropic kuratierte First-Party-Directory anthropics/claude-plugins-official: automatisch beim Start verfügbar, kein manuelles Hinzufügen mehr. Entdecken über /plugin > Discover, installieren über /plugin install <name>@claude-plugins-official. Das Repository selbst ist in zwei Ordner geteilt: plugins/ (Anthropic-intern kuratiert) und external_plugins/ (Community und Partner, quality- und security-gated mit eigenem Submission-Formular).
Zwei Workflow-Erleichterungen sind dabei spürbar: Plugins, die in .claude/skills liegen, laden jetzt automatisch — der Umweg über den Marketplace entfällt. Und ein eigenes Plugin zu bauen ist ein Einzeiler geworden: claude plugin init <name> scaffoldet die Struktur, /plugin list --enabled/--disabled zeigt den Zustand.
# Plugin aus dem offiziellen Marketplace installieren
claude /plugin install code-review@claude-plugins-official

# Eigenes Plugin scaffolden
claude plugin init my-plugin
Das von Anthropic kuratierte Set ist überschaubar und genau deshalb brauchbar: code-review, skill-creator, hookify, plugin-dev, mcp-server-dev, feature-dev — dazu die Baseline aus commit-commands und pr-review-toolkit. Besonders praktisch: /code-review --fix wendet Review-Findings direkt auf den Working Tree an — der Apply-Schritt zwischen „Review findet etwas" und „Fix landet im Code". Bei mir ist es verfügbar; das --fix-Flag selbst habe ich aber noch nicht im Scharfschuss laufen lassen. Auch die per-Sprache-LSP-Plugins (pyright-lsp, typescript-lsp, rust-analyzer-lsp und weitere) sind hier formalisiert: Das Language-Server-Thema der Baseline ist jetzt im Marketplace kuratiert, statt von Hand verdrahtet zu werden.
Zwei Detail-Verbesserungen erleichtern das Arbeiten in größeren Setups deutlich. Erstens: verschachtelte .claude/-Verzeichnisse (v2.1.178). Bei Namenskollisionen gewinnt jetzt die Definition, die dem Arbeitsverzeichnis am nächsten liegt — für Agents, Workflows und Output-Styles. Skills verhalten sich bewusst anders: Bei einem Namens-Clash bleiben beide erhalten, der verschachtelte erscheint als <dir>:<name> (bei mir etwa mayflow:update), sodass nichts verloren geht. Für Monorepos und Multi-Workspace-Arbeit heißt das: Jeder Teil-Workspace kann seine eigene Konfiguration tragen, ohne dass ich global etwas anfassen muss. Zweitens: Skill-Hot-Reload. Den gab es schon; v2.1.174 hat ihn so gefixt, dass eine einzelne Skill-Änderung nur diesen einen Skill neu ankündigt statt der ganzen Liste (das spart Tokens), und /reload-skills (v2.1.152) re-scannt die Skill-Verzeichnisse ohne Session-Neustart. Das verstärkt die „Iteration über Perfektion"-Praxis aus dem März direkt: Ich schreibe einen Skill, teste ihn, passe ihn an — ohne die Session jedes Mal wegzuwerfen.
Was den Marketplace für mich wirklich brauchbar macht, ist nicht die schiere Auswahl, sondern dass er die Kontext-Kosten sichtbar macht. Das Browse-Pane zeigt die projizierten Kontext-Kosten eines Plugins, bevor ich es installiere, listet vorab die enthaltenen Komponenten und erzwingt Abhängigkeiten — und es gibt eine Suchleiste. Das passt exakt zur Serien-Disziplin: Jedes Plugin kostet Tokens beim Startup, und meine Frage bleibt unverändert „löst das ein echtes Problem?". Ein Marketplace, der die Kosten gleich mit anzeigt, beantwortet die Frage halb von selbst. (Ob diese Tooling-Reife genau ins März-Fenster fällt, ist unscharf — sie ist eher eine Reifung über diesen Zeitraum als ein hartes „neu seit März".)
Beim MCP-Setup hat sich derweil Claude in Chrome weiterentwickelt: Multi-Browser-Auswahl und gebündeltes Tool-Loading ergänzen die Browser-DevTools-MCPs der Baseline. Damit trägt der Browser-Refresh die MCP-Aktualisierung dieser Ausgabe. Daneben bleibt ContextMine mein Werkzeug für interne Dokumentation — projektweise eingesetzt, wenn ein Projekt eigene Dokus hat, die Context7 nicht abdeckt (öffentlich vs. intern, sauber getrennt). Eine Praxis-Notiz am Rand, falls jemand MCPs projektweise verwaltet: Das Deaktivieren läuft pro Projekt — disabledMcpServers greift nicht global, der Disable-Schalter sitzt unter /plugin, und die CLI kennt kein disable, nur remove.
Memory: Vom Session-Mining zum auto-geladenen System
Im März habe ich Session-Mining beschrieben: Claude liest seine eigenen JSONL-Logs, wenn ich es explizit anweise. Das war pragmatisch, aber manuell. Inzwischen ist daraus ein strukturiertes, automatisch geladenes Memory-System geworden — und das ist die eigentliche Transformation dieser Sektion.
Der Kern: Ein SessionStart-Hook injiziert beim Start einen globalen Memory-Index. Ich muss nichts mehr von Hand laden; der relevante Kontext ist da, bevor ich das erste Wort tippe.
Das Muster dahinter ist file-basiert und braucht Pflege-Disziplin, sonst kippt der Vorteil ins Gegenteil. Drei Bausteine prägen mein Setup:
- Tiered Sub-Indizes: Große, themen-gebundene Cluster wandern in lazy geladene
MEMORY-<SLUG>.md-Dateien, die nicht automatisch in jede Session kommen. Der Haupt-Index hält pro Cluster nur eine Stub-Zeile mit Trigger-Stichworten. So bleibt der auto-geladene Hot-Path schlank — denn jede Zeile im Index kostet bei jedem Session-Start Kontext. - Frontmatter-Schema: Jede Memory-Datei trägt Metadaten (Name, Beschreibung, Typ), damit Routing und Wartung funktionieren.
- Cross-Links: Memories verweisen aufeinander, sodass verwandte Notizen sich gegenseitig finden.
Der konzeptionell wichtigste Teil ist aber eine Regel, kein Mechanismus: Memory gegen die Realität validieren. Memory ist ein Snapshot vom Zeitpunkt des Schreibens, kein Live-Feed. Versionen, Pfade, Flags, Tool-Verfügbarkeit ändern sich. Bevor ich eine schwer umkehrbare oder nach außen gerichtete Aktion auf eine erinnerte Tatsache stütze, prüfe ich sie gegen Ground Truth — Dateisystem, git-Status, eine laufende Version. Die Erinnerung ist der Startpunkt, nicht das letzte Wort.
★ Insight ──────────────────────────────────────────────────────────────────Auto-geladenes Memory ist ein zweischneidiges Schwert: Es schenkt Kontext, verlangt aber Pflege-Disziplin als Gegenleistung. Die eigentliche Kunst liegt nicht im Sammeln, sondern im schlank gehaltenen Index — denn was auto-lädt, kostet bei jedem Session-Start Tokens. Ein Memory-System, das alles behält, erstickt am eigenen Hot-Path.
────────────────────────────────────────────────────────────────────────────
Best Practices: Hooks als Policy-Engine, Specs als ADRs
Was im März noch lose „Best Practices" hieß, hat sich zu etwas Konkreterem verdichtet: Hooks sind bei mir keine Convenience mehr, sondern eine Policy-Engine. Sie kodieren Geschäftsregeln, die das Werkzeug erzwingt — statt dass ich mich daran erinnern muss.
- Hooks als Enforcement-Rückgrat (Muster-Ebene): Vier Hook-Events tragen das Setup. SessionStart injiziert den Memory-Index. PostToolUse arbeitet als Guard und armt Automatismen. Stop erinnert an offene Commits/Pushes. PreToolUse schützt vor riskanten Worktree-Operationen. Der Changelog hat den Spielraum direkt vergrößert: ein
MessageDisplay-Hook kann Assistant-Output transformieren oder verstecken (v2.1.152),SessionStartkannreloadSkillsundsessionTitlesetzen (v2.1.152), und Stop/SubagentStop-Hooks könnenadditionalContextzurückgeben (v2.1.163) — alles in meinem Build. - Granulare Permission-Syntax: Permission-Regeln matchen jetzt Tool-Parameter, nicht nur Tool-Namen —
Tool(param:value). Damit lässt sich etwaAgent(model:opus)gezielt blocken, um teure Opus-Subagenten auszuschließen;*-Wildcards funktionieren. (v2.1.178) Das passt exakt zu einem permission-getriebenen Setup. - Destruktive Git-Kommandos in Auto Mode geblockt:
git reset --hard,git checkout -- .,git clean -fd,git stash dropwerden in Auto Mode blockiert, sofern ich sie nicht explizit als Discard anfordere (v2.1.183). Bei einem worktree- und force-push-lastigen Git-Workflow ist das ein echter Datenverlust-Schutz. /safe-modefürs Troubleshooting:--safe-modedeaktiviert CLAUDE.md, Plugins, Skills, Hooks und MCP auf einen Schlag (v2.1.169). Genau bei einem hook- und skill-lastigen Setup ist das Gold wert, wenn etwas klemmt und ich die Ursache isolieren will.
Der zweite Strang ist die Spec→ADR-Härtung — die direkte Fortschreibung von „SDD als täglicher Workflow" aus dem März, jetzt mit Artefakt-Hygiene. Roh-Specs aus brainstorming werden nach der Umsetzung bewusst verworfen — oder, nur bei einer architekturwürdigen Entscheidung, zu einem MADR-4.0-ADR destilliert. Ein PostToolUse-Hook fängt Specs ab, die am falschen Ort landen. Aus genau dieser Praxis ist auch ein konkretes Artefakt entstanden: ein teilbarer excalidraw-generation-Skill (erzeugt .excalidraw-Diagramme programmatisch und dokumentiert den PNG-Export-Weg) — ein Lehrbeispiel der 3×-Regel, jetzt mit dem zusätzlichen Schritt vom wiederholten Bedarf zum exportierbaren Skill. Am Rand noch ein Teaser: An etwas mit dem Arbeitsnamen SAGE arbeite ich gerade — mehr dazu verrate ich später.
Zwei kleine IDE-Notizen am Rand: /terminal-setup behebt den GPU-bedingten Garbled-Text in VS Code, Cursor und Windsurf (v2.1.157/160). Und zwei neue Commands haben sich eingebürgert: /cd wechselt das Session-Verzeichnis ohne Cache-Bruch (v2.1.169), /config key=value setzt Inline-Settings (v2.1.181).
Where Things Stand: Was ich beobachte, aber noch nicht nutze
Nicht alles, was im Fenster passiert ist, läuft bei mir schon produktiv. Drei Dinge beobachte ich — ehrlich als Sneak-Peek, nicht als Hands-on.
Agent Teams sind die experimentelle Vollform der Orchestrierung. Hinter dem Env-Flag CLAUDE_CODE_EXPERIMENTAL_AGENT_TEAMS=1 verbergen sich echte Peer-Instanzen von Claude Code, jede mit eigenem Kontextfenster, die direkt miteinander kommunizieren — anders als Subagenten, die nur an den Lead zurückmelden. Koordiniert wird über eine geteilte Task-Liste mit Dependency-Tracking, File-Locking und Mailbox-Messaging. Das ist die echte Multi-Instanz-Variante, die das Baseline-Pattern formalisiert. Aber: default-aus, experimentell, Stabilität und Adoption unbewiesen — also beobachte ich es, statt es zu empfehlen. Die jüngere Mechanik (native iTerm2-Panes, v2.1.186) ist angekündigt, steckt aber nicht in meinem Build.
Fable 5 hatte vielleicht das kürzeste Leben, das ich bei einem Modell je gesehen habe. Anthropic stellte das „Mythos-class"-Modell — angesiedelt über der Opus-Klasse — am 9. Juni 2026 allgemein bereit und schaltete es drei Tage später wieder ab, nachdem die US-Regierung eine Export-Control-Direktive aus Gründen der nationalen Sicherheit erlassen hatte. Bis heute ist der Zugang nicht zurück; die genauen Hintergründe hat die Regierung offiziell nicht dargelegt. Testen lässt sich also nichts — aber als Präzedenzfall, wie schnell ein Frontier-Modell wieder verschwinden kann, bleibt es im Blick.
Und schließlich eine ehrliche Recherche-Grenze. Was Anthropic offiziell ausliefert und empfiehlt, ist gut belegt und teils selbst getestet. Was „die Community am meisten nutzt", ist deutlich weicher als die kursierenden Zahlen suggerieren: Aggregat-Metriken — Star-Leaderboards, Install-Counts, Directory-Größen — haben die adversariale Verifikation nicht überstanden, und benannte Experten-Empfehlungen jenseits Anthropics ließen sich nicht zweifach unabhängig bestätigen. In der Landschaft existieren Community-Marketplaces wie wshobson/agents; ich nenne sie als Landschaft, nicht als Empfehlung. Mein kuratierter Stil bleibt: Was nicht belegbar ein echtes Problem löst, kommt nicht in den Stack.
Fazit: Wer dirigiert — und auf welcher Ebene?
Zurück zur Eröffnungsfrage: Wer dirigiert die Arbeit — und auf welcher Ebene? Der Stack ist erstaunlich stabil geblieben, und meine Arbeitsweise auch: Ich jongliere weiter mehrere Fenster, Aufgaben und Projekte von Hand. Die Verschiebung liegt nicht darüber, sondern darunter — eine Ebene tiefer, innerhalb der einzelnen Aufgabe. Dort dirigiere nicht mehr ich jeden Schritt, sondern das Werkzeug orchestriert seine Subagenten selbst. Die ehrliche Antwort lautet also zweistufig: Über den Aufgaben dirigiere weiter ich — innerhalb einer Aufgabe jetzt zunehmend das Werkzeug.
Wie immer: kein abgeschlossener Prozess, ein Snapshot, der sich weiterentwickeln wird. Orchestrierung ist noch jung — der Bug-Caveat um verschachtelte Subagenten und die experimentellen Teile bleiben im Blick. Aber die Richtung ist klar. Es geht nicht mehr nur um welche Werkzeuge — sondern darum, wer welche Ebene der Arbeit dirigiert.
Dieser Artikel erschien ursprünglich auf dem Mayflower Blog.